
Sommaire
Le fichier llms.txt est un résumé de votre site au format Markdown, placé à sa racine, destiné aux modèles de langage comme ceux de ChatGPT ou de Claude. Google l'écrit dans sa documentation depuis le 15 mai 2026 : Google Search l'ignore, il n'aide ni ne nuit à votre visibilité, AI Overviews et mode IA compris. Côté IA, les mesures de 2026 vont dans le même sens : dans la plus grande étude publiée, 97 % des fichiers llms.txt n'ont reçu aucune requête en un mois. Pour une TPE ou une PME, ce n'est donc pas une priorité. Voici ce que disent les sources officielles et les études, dans quels cas le fichier peut servir, et ce qui aide vraiment à être cité par Google et par les IA.
Qu'est-ce que le fichier llms.txt ?#
Le llms.txt a été proposé le 3 septembre 2024 par Jeremy Howard, cofondateur d'Answer.AI. L'idée : les pages web sont pleines de menus, de scripts et de publicités, et un modèle de langage qui cherche une information a intérêt à trouver un résumé propre, au même endroit sur chaque site. La spécification, mise à jour en août 2026, décrit un fichier Markdown placé à l'adresse /llms.txt, avec dans l'ordre :
- un titre de niveau 1 avec le nom du site, seule partie obligatoire ;
- une citation qui résume le site en quelques lignes ;
- des paragraphes libres ;
- des sections de liens, chacune au format
[nom de la page](adresse): note; - une section « Optional » pour les liens secondaires.
Pour un artisan, cela donnerait par exemple :
# Plomberie du Centre

> Plombier chauffagiste au Mans depuis 2009 : dépannage, installation
> de chaudières et rénovation de salles de bains en Sarthe.

## Services

- [Dépannage plomberie](https://exemple.fr/depannage): intervention sous 2 h au Mans
- [Installation de chaudière](https://exemple.fr/chaudiere): gaz et granulés, devis gratuit

## Optional

- [Nos réalisations](https://exemple.fr/realisations)
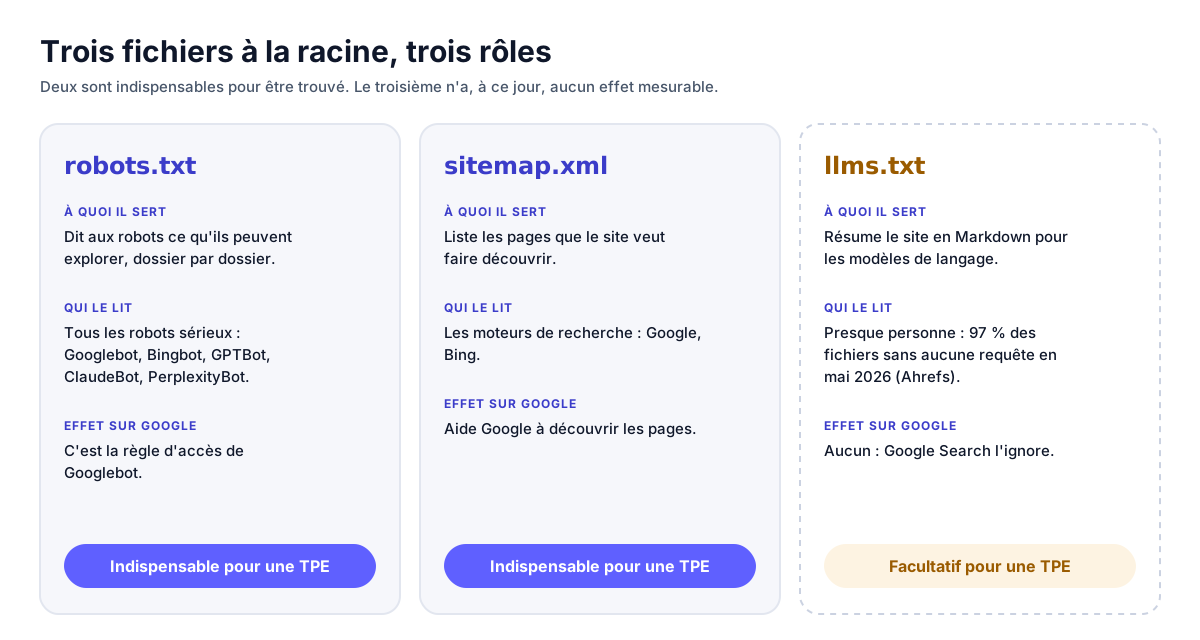
Deux précisions qui évitent des confusions fréquentes. Le fichier llms-full.txt, qui contient le texte complet de toutes les pages, ne fait pas partie de la spécification : c'est une convention lancée par Mintlify, un éditeur d'outils de documentation. Et le llms.txt ne remplace pas le robots.txt : la spécification elle-même rappelle que les deux fichiers ont des rôles différents. L'un donne des règles d'accès, l'autre propose un résumé.
Ce que Google en dit officiellement#
La position de Google n'est plus une rumeur de forum : elle est écrite dans sa documentation.
Le guide du 15 mai 2026. Google a publié ce jour-là un guide d'optimisation pour l'IA générative dans la recherche, présenté par John Mueller. Une rubrique entière démonte les idées reçues, dont celle-ci. En substance : vous n'avez pas besoin de créer de nouveaux fichiers lisibles par les machines, de fichiers texte pour l'IA ni de Markdown pour apparaître dans Google Search, y compris dans ses fonctions d'IA générative, parce que Google Search ne les utilise pas. Et si vous tenez un llms.txt pour d'autres services, c'est permis : cela n'aidera ni ne nuira à votre visibilité, puisque Google l'ignore. Le guide range la création de « fichiers texte IA inutiles (comme llms.txt) » parmi les tactiques à laisser de côté.
La précision du 15 juin 2026. Google a ajouté une note dans le journal des mises à jour de sa documentation : ces fichiers ne sont pas nécessaires pour Google Search et n'ont d'effet ni positif ni négatif sur la visibilité ou le classement.
Les déclarations de ses porte-parole. Elles vont toutes dans le même sens depuis 2025 :
- En juillet 2025, Gary Illyes a déclaré lors d'une conférence Search Central à Bangkok que Google ne prenait pas en charge llms.txt et ne prévoyait pas de le faire, selon les comptes rendus de Search Engine Land. Il l'a comparé ensuite à la balise meta keywords des années 1990, que les moteurs ont cessé d'utiliser parce que chacun y écrivait ce qu'il voulait.
- Le 20 mai 2026, interrogé sur les llms.txt présents sur certains sites de Google, John Mueller a répondu que ce n'était pas fait pour la recherche. Pour les sites qui ne sont pas des documentations techniques, il ne voit pas l'intérêt du fichier, même avec la montée des agents IA, et résume : une version Markdown des caractéristiques d'une chaussure ne fera pas vendre plus de chaussures.
- Dans le podcast Search Off the Record du 15 juin 2026, il ajoute qu'un fichier rédigé par le site lui-même ne peut pas servir à départager des sites, puisque chacun y écrit ce qu'il veut.
Les faits qui semblent contredire Google. Plusieurs sites de Google publient un llms.txt : c'est le cas, au 26 octobre 2026, de la documentation de l'API Gemini (ai.google.dev), de developer.chrome.com et de web.dev. Ce sont des documentations destinées aux développeurs et à leurs assistants de programmation, pas un signal pour le moteur de recherche. Interrogé en janvier 2026 pour savoir si ces fichiers valaient approbation, John Mueller a répondu par un « non » sans détour. De même, l'outil Lighthouse de Chrome propose désormais un contrôle du llms.txt dans une catégorie expérimentale consacrée à la navigation par des agents : un site sans fichier n'y est pas pénalisé, le contrôle est simplement marqué « non applicable ».
Les robots des IA le lisent-ils ?#
C'est la vraie question pour qui veut être cité par ChatGPT, Claude ou Perplexity. Deux sources permettent d'y répondre : ce que les éditeurs d'IA documentent, et ce que les journaux des serveurs enregistrent.
Ce que disent les éditeurs. Les pages officielles qui décrivent les robots d'OpenAI, d'Anthropic, de Perplexity et de Mistral ne parlent que de robots.txt. Aucune n'annonce que leurs robots lisent le llms.txt des sites qu'ils visitent. Ces quatre entreprises publient pourtant un llms.txt pour leur propre documentation : publier le fichier pour aider les développeurs qui utilisent leurs outils, ce n'est pas le lire chez les autres.
Ce que mesurent les journaux des serveurs. Trois études publiées en 2026 se recoupent :
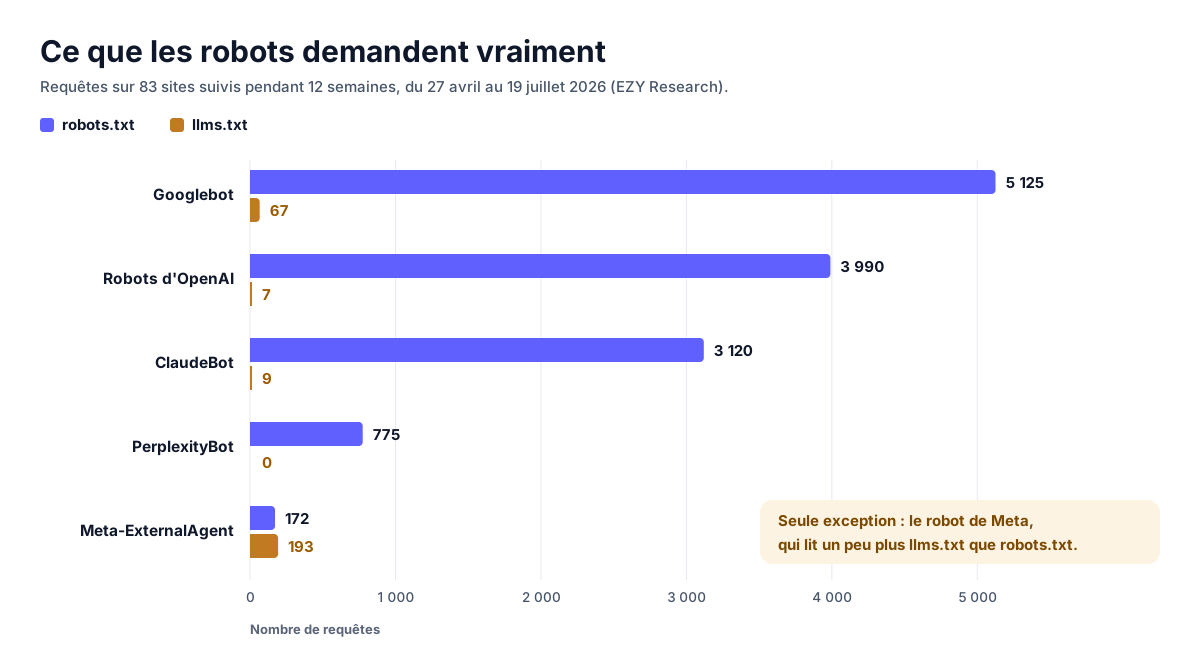
- Ahrefs a analysé les journaux de 137 210 domaines en mai 2026. 28 % publient un llms.txt, un plafond selon l'étude, car ses clients sont plus techniques que la moyenne. 97 % de ces fichiers n'ont reçu aucune requête dans le mois. Sur les requêtes restantes, les robots de recherche des IA (OAI-SearchBot, PerplexityBot et les autres) en pèsent 1,1 %.
- EZY Research a suivi 83 sites pendant 12 semaines, d'avril à juillet 2026, en comptant pour chaque robot les demandes de robots.txt et de llms.txt. Le résultat est dans le graphique ci-dessous.
- SE Ranking a étudié près de 300 000 domaines : 10,13 % ont un llms.txt, et sa présence n'a aucun effet sur la fréquence à laquelle un domaine est cité par les IA.
Notre propre fichier va dans le même sens. Get Ranking publie un llms.txt depuis fin avril 2026. L'outil d'inspection d'URL de Search Console montre que Googlebot l'a exploré le 23 octobre 2026, sans l'indexer : Google le visite comme n'importe quel fichier du site, sans lui accorder de traitement particulier. C'est exactement ce que dit sa documentation.
Faut-il quand même en créer un ?#
Le fichier ne coûte presque rien et Google dit lui-même qu'il ne nuit pas. La question n'est donc pas « est-ce dangereux ? » mais « est-ce que c'est le meilleur usage de votre temps ? ». Pour la plupart des entreprises, la réponse est non.
Les cas où il peut servir. Une documentation technique, une API, un logiciel : les assistants de programmation et les agents qui travaillent sur une documentation peuvent s'en servir, et c'est d'ailleurs pour ces usages que Google, OpenAI ou Anthropic en publient un. John Mueller le formule ainsi : si un système automatisé est déjà sur votre site, un tel fichier peut l'aider à s'orienter.
Les cas où il ne sert à rien. Un site vitrine d'artisan, de commerçant ou de cabinet, un site e-commerce de taille modeste. Aucun moteur ne s'en sert pour classer les pages, et presque aucun robot d'IA ne le demande.
La règle pour trancher. John Mueller en a donné une en juillet 2025 : si un système d'IA qui vous envoie un trafic significatif demande votre llms.txt aussi souvent que votre robots.txt dans les journaux de votre serveur, il sera temps d'y penser. Aujourd'hui, les mesures ci-dessus montrent qu'on en est loin.
Si vous en publiez un quand même, trois précautions :
- Ne recopiez pas vos pages en entier. Un fichier qui reprend le texte de vos pages fait doublon. John Mueller suggère dans ce cas de l'exclure de l'index, avec un en-tête HTTP
X-Robots-Tag: noindex, pour qu'il n'apparaisse pas dans Google à la place de vos pages. - Ne créez pas de versions Markdown de tout le site. Les porte-parole de Google déconseillent de maintenir des pages en double pour les machines : deux versions à tenir à jour, pour aucun gain mesuré.
- N'écrivez rien que vous n'écririez pas sur vos pages. Ahrefs a repéré un robot qui étudie systématiquement les llms.txt comme porte d'entrée pour des injections d'instructions. Le fichier est public : restez factuel.
Si votre CMS ou votre extension SEO génère le fichier automatiquement, ce qui est le cas de près d'un tiers des llms.txt selon SEOmator, inutile de le désactiver. Inutile aussi d'y passer une journée.
Ce qui marche à la place#
Pour être trouvé par Google et cité par les IA, les leviers sont connus, documentés, et beaucoup plus rentables.
1. Ouvrir la porte aux bons robots dans le robots.txt#
C'est le robots.txt, pas le llms.txt, qui décide si un robot peut lire vos pages. Les éditeurs d'IA séparent désormais les robots qui entraînent leurs modèles de ceux qui cherchent des réponses pour leurs utilisateurs. Vous pouvez refuser les premiers et accepter les seconds :
| Robot | Éditeur | Rôle selon sa documentation |
|---|---|---|
| Googlebot | Recherche Google, AI Overviews et mode IA compris | |
| Google-Extended | Entraînement de Gemini ; sans effet sur la recherche Google ni le classement | |
| OAI-SearchBot | OpenAI | Recherche de ChatGPT |
| GPTBot | OpenAI | Entraînement des modèles |
| Claude-SearchBot | Anthropic | Recherche de Claude |
| ClaudeBot | Anthropic | Entraînement des modèles |
| PerplexityBot | Perplexity | Recherche de Perplexity, sans entraînement |
OpenAI l'écrit explicitement : un site peut autoriser OAI-SearchBot pour apparaître dans les résultats de recherche de ChatGPT tout en refusant GPTBot. Attention à deux pièges. Bloquer Google-Extended ne vous retire pas des AI Overviews, qui passent par Googlebot. Et si votre site passe par Cloudflare, vérifiez vos réglages : depuis le 1er juillet 2025, Cloudflare bloque par défaut les robots d'IA sur les nouveaux domaines, ce qui peut vous rendre invisible dans ChatGPT sans que vous l'ayez décidé. Notre générateur de robots.txt prépare un fichier propre en quelques clics.
2. Faire indexer vos pages, et les rendre éligibles à l'extrait#
Pour Google, la condition d'accès aux AI Overviews et au mode IA tient en une phrase de sa documentation : la page doit être indexée et pouvoir s'afficher dans la recherche avec un extrait. Aucune autre exigence, aucun fichier spécial. Vérifiez donc dans Google Search Console que vos pages importantes sont bien indexées, et qu'aucune balise nosnippet ou max-snippet trop restrictive ne les empêche d'être citées. Notre guide du référencement Google gratuit montre comment lire l'inspection d'URL pas à pas.
3. Écrire ce que les autres n'écrivent pas#
Le guide de Google insiste sur un contenu « non banal » : une page qui apporte quelque chose que dix autres pages ne disent pas déjà. Pour une PME, ce sont vos prix réels, vos délais, vos cas clients, vos photos de chantier, les questions que vos clients vous posent au téléphone. Les données structurées ne sont pas obligatoires pour l'IA générative, précise Google ; elles restent utiles pour les résultats enrichis classiques.
4. Soigner sa fiche Google#
Google cite la fiche d'établissement et Merchant Center parmi ce qui aide vos produits et services à apparaître à la fois dans les réponses IA et dans les résultats classiques. Pour une entreprise locale, c'est souvent le levier le plus rapide : suivez notre guide de la fiche d'établissement Google.
5. Mesurer au lieu de supposer#
Si vous voulez savoir quels robots visitent votre site, regardez les journaux de votre serveur : ils disent qui demande quoi, et à quelle fréquence. Pour la visibilité dans les réponses des IA, notre guide du GEO détaille la méthode de suivi mois par mois, et notre article sur le référencement dans ChatGPT, Perplexity et Gemini les leviers propres à chaque assistant.
En résumé#
Le llms.txt est une bonne idée de développeur, utile pour des documentations techniques. Pour être trouvé dans Google et cité par les IA, il ne sert à rien à ce jour : Google l'ignore et le dit dans sa documentation, les éditeurs d'IA n'annoncent pas le lire, et les journaux de serveurs montrent que leurs robots le demandent presque jamais. Les leviers qui comptent sont ailleurs : un robots.txt qui laisse passer les robots de recherche, des pages indexées et éligibles à l'extrait, un contenu que les autres n'ont pas, une fiche Google complète.
Première étape : lancez un audit SEO gratuit pour vérifier que vos pages sont indexées et lisibles par les robots. Et si vous voulez un plan complet pour être cité par les IA, c'est le travail de notre agence GEO : un état des lieux de votre présence dans les réponses, puis un suivi mensuel. Personne ne peut garantir une citation dans une réponse générée, et nous ne le promettons pas.